
Case
Como a Starya criou uma plataforma de inferência na AWS para seus agentes de IA em saúde com a Elevata
91%
do tráfego de seis agentes corporativos migrados atendido por GPUs dedicadas na AWS na implantação inicial, em junho de 2026
- Indústria
- IA aplicada / Saúde e seguros
- Região
- Brasil
- Arquitetura
- Gateway de modelos com inferência em GPUs e Amazon Bedrock
Sobre a empresa
A Starya desenvolve agentes de IA que conectam conversas aos sistemas e fluxos de trabalho que as empresas usam para atender seus clientes. Sua plataforma NebulaOS conecta modelos de linguagem, fontes de dados e ferramentas, e dá suporte a aplicações como agendamento de pacientes, atendimento ao cliente e administração em saúde.
Para quem está tentando marcar uma consulta ou resolver uma solicitação de atendimento, um agente útil precisa fazer mais do que produzir uma resposta plausível. Ele precisa entender o pedido, usar as informações certas, chamar as ferramentas adequadas e dar continuidade à conversa. A Starya incorpora essas capacidades às operações dos seus clientes, inclusive em ambientes de saúde e seguros, em que precisão, privacidade e continuidade são importantes.
A Starya contratou a Elevata, AWS Advanced Tier Services Partner, para avaliar alternativas aos serviços de modelos que já usava e criar uma plataforma de inferência na AWS. O objetivo era preservar a qualidade dos seus agentes e, ao mesmo tempo, ganhar mais controle sobre a escolha de modelos, a infraestrutura e o custo de operação.
O desafio
À medida que os agentes da Starya atendiam mais conversas, o uso de modelos de linguagem se tornou um custo variável importante. No início do projeto, a Starya informou gastar cerca de R$ 320 mil por mês com serviços de modelos de terceiros. Os custos cresciam com a quantidade de informação que cada modelo processava, e a equipe precisava de mais visibilidade sobre o custo de atender cada cliente.
Trocar de modelo também trazia um risco para o produto. Um agente que agenda consultas precisa escolher as ferramentas certas, trabalhar com as informações devolvidas por essas ferramentas e se comunicar de forma natural com a pessoa que pede ajuda. Um modelo que vai bem em um benchmark genérico pode se comportar de outra forma nesse fluxo.
A Starya precisava estabelecer quais modelos poderiam sustentar seus próprios agentes e se uma infraestrutura dedicada de GPUs conseguiria atendê-los com confiabilidade. A decisão precisava considerar, em conjunto, a qualidade das respostas, a latência, o volume das cargas de trabalho e a utilização da infraestrutura. A empresa também queria mais controle sobre o ambiente que processa suas cargas de trabalho de IA, principalmente nas aplicações de saúde.
A solução
O trabalho da Starya e da Elevata passou pela avaliação de modelos, por testes de infraestrutura e por uma implantação controlada em produção.
A primeira avaliação comparou 17 modelos com 95 exemplos de um agente de agendamento representativo da Starya. A análise examinou tom de voz, uso de ferramentas, segurança e proatividade, além da exatidão das respostas e do grounding, ou seja, se as respostas se mantinham fiéis às informações disponíveis. A Starya contribuiu com seu pipeline de avaliação e sua experiência na operação dos agentes; a Elevata forneceu o ambiente de inferência na AWS e o suporte de engenharia.
A avaliação identificou modelos open-weight capazes de competir com os serviços existentes em indicadores de qualidade importantes. O Gemma pontuou acima do modelo de referência em produção em exatidão e grounding, e o Qwen obteve o melhor resultado de grounding do grupo testado. As diferenças no uso de ferramentas e no comportamento conversacional ajudaram as equipes a identificar candidatos para validação adicional nos fluxos da Starya.
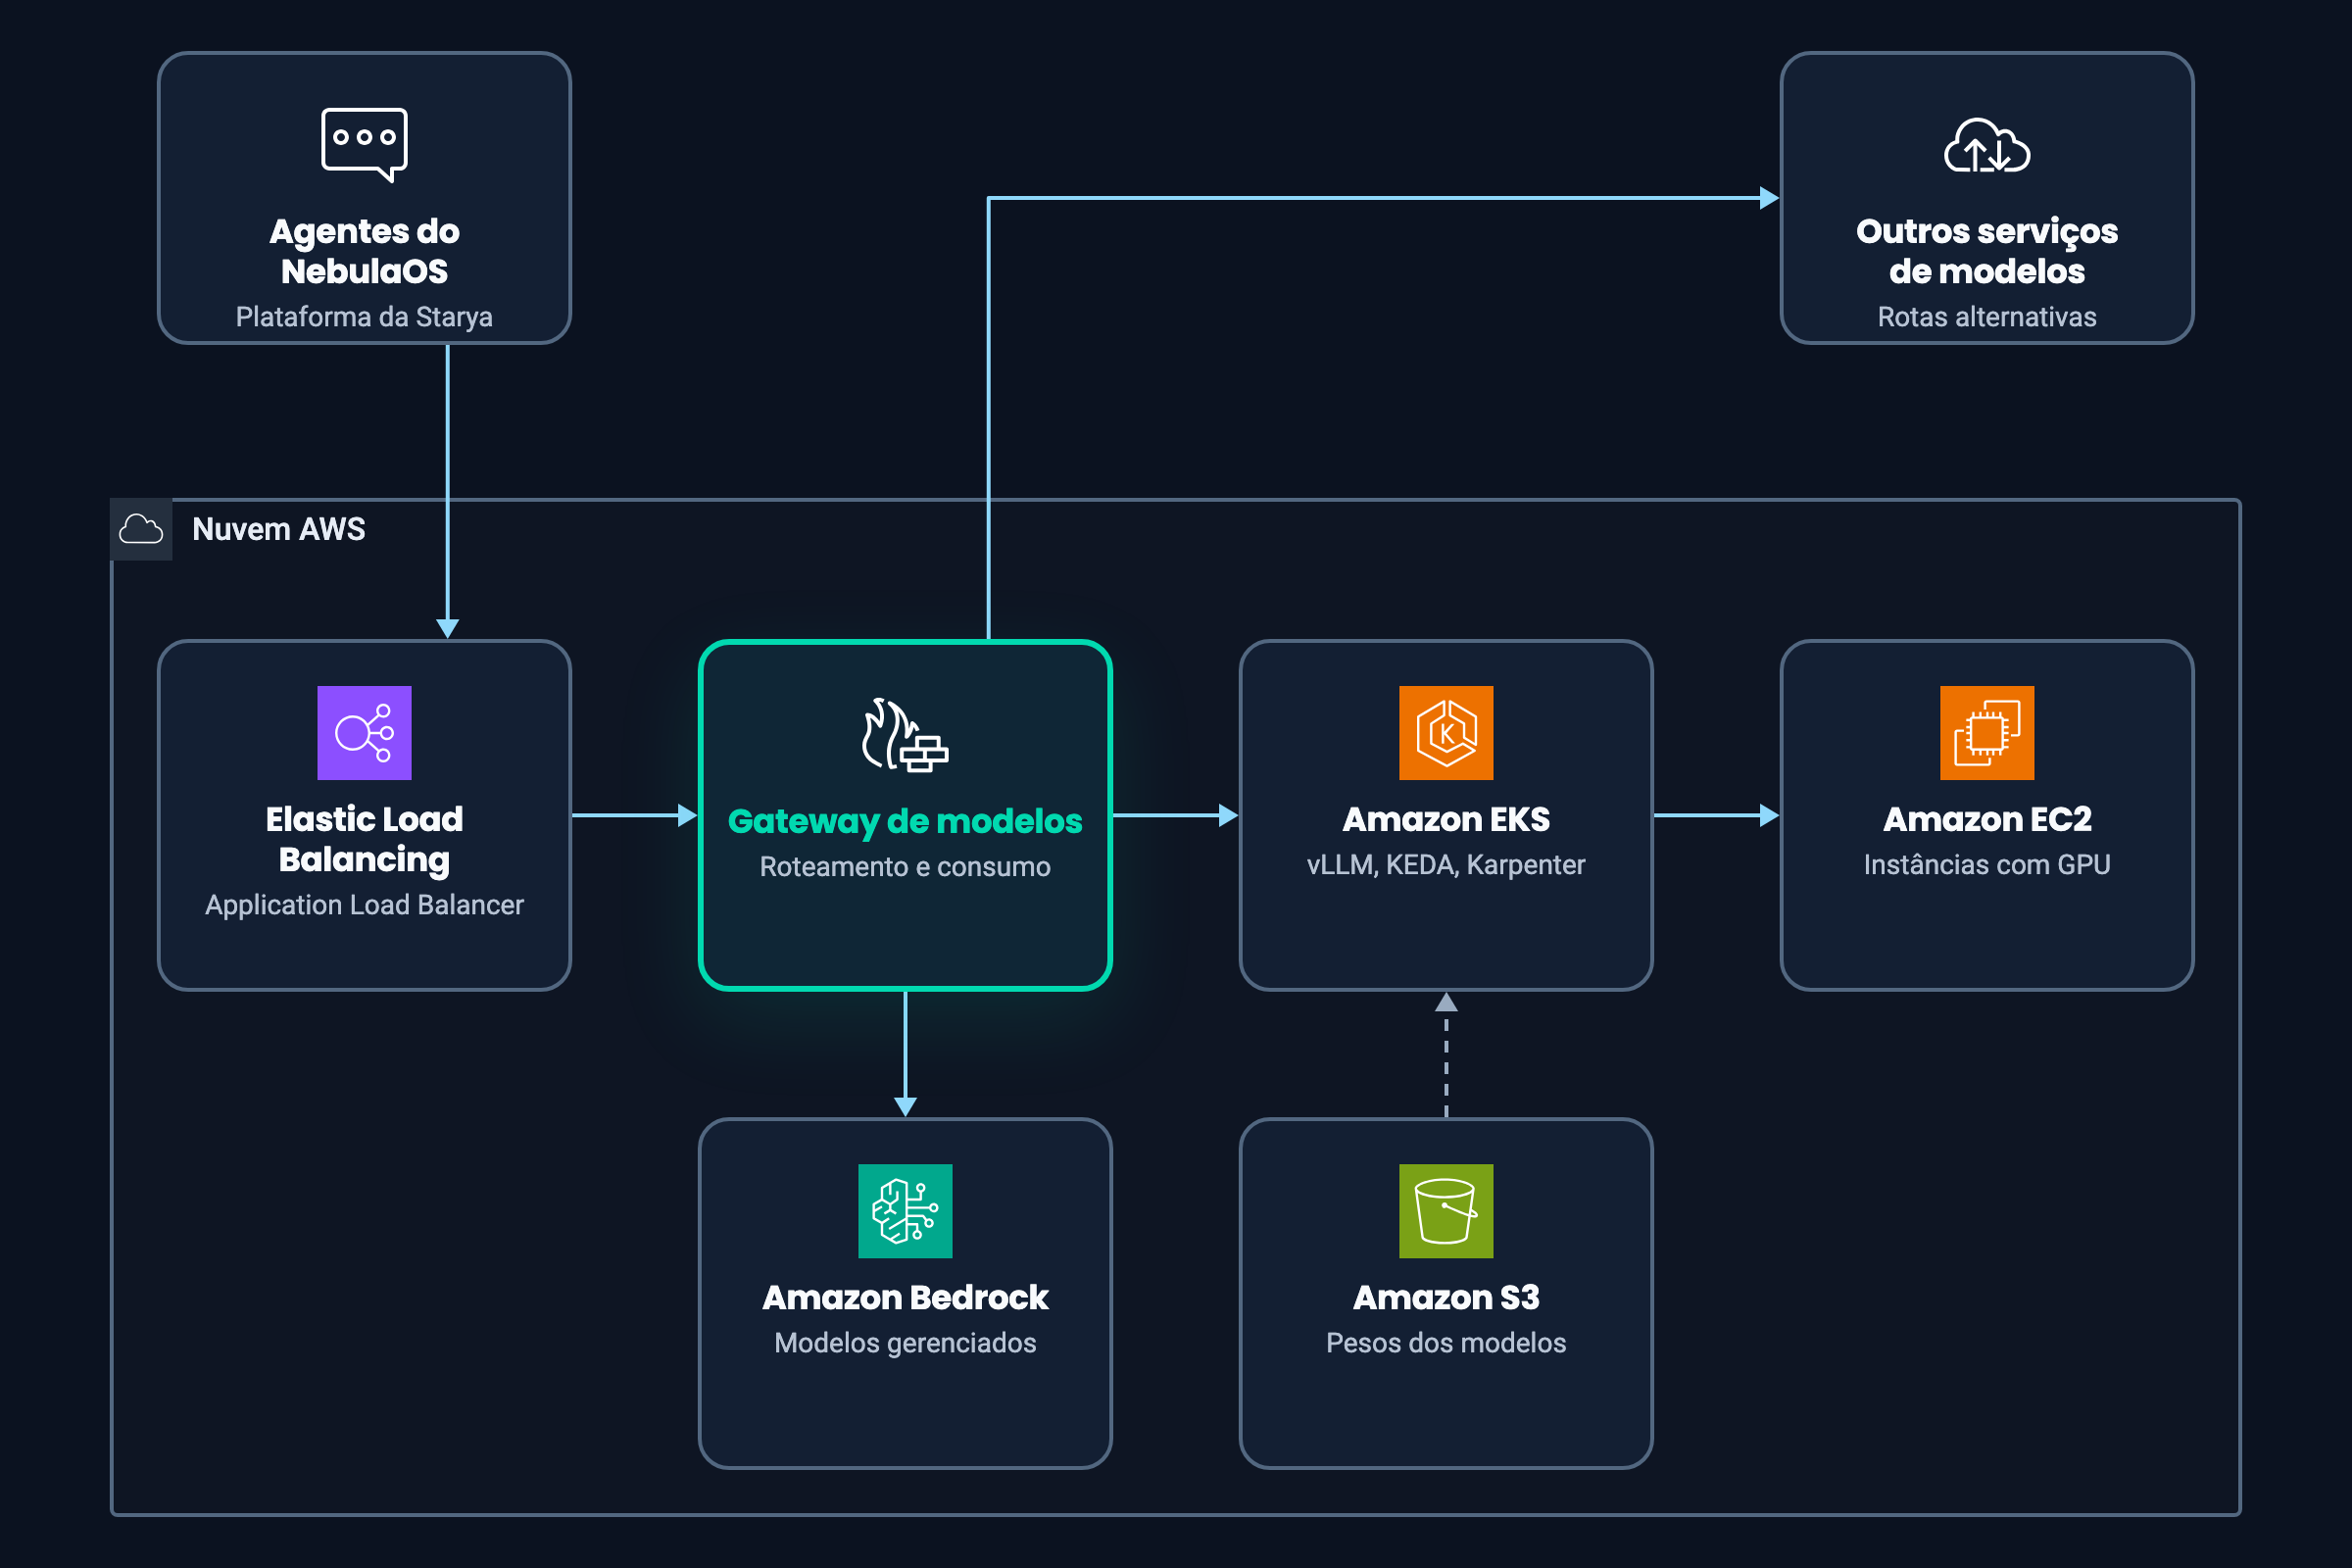
Em seguida, a Elevata construiu na AWS a infraestrutura para servir os modelos. Os modelos open-weight rodaram com vLLM no Amazon EKS, usando instâncias com GPU do Amazon EC2. O Amazon S3 armazenou os pesos dos modelos. Um gateway de modelos compartilhado conectou os agentes do NebulaOS à inferência dedicada em GPUs, ao Amazon Bedrock e a outros serviços de modelos configurados.
Esse gateway deu às equipes um ponto comum para rotear requisições, monitorar o uso e atribuir o consumo a cada cliente. Ele também permitiu que o modelo e a infraestrutura que atendem uma carga de trabalho evoluíssem sem exigir que todas as aplicações de clientes fossem migradas ao mesmo tempo.
As equipes testaram a infraestrutura antes de ampliar o tráfego de produção. Os testes de carga examinaram tempos de resposta, capacidade, overhead de roteamento e comportamento de escalonamento. O KEDA e o Karpenter forneceram os mecanismos de escalonamento das réplicas dos modelos e dos nós de GPU, enquanto o monitoramento ajudou os engenheiros a entender como a demanda e os prompts longos afetavam o desempenho.
A implantação levou agentes corporativos selecionados para o caminho de GPUs na AWS, com serviços de modelos alternativos disponíveis pelo gateway. A arquitetura também suportava o Amazon Bedrock como rota principal, o que deu à Starya flexibilidade para ajustar sua combinação de modelos conforme a qualidade, o desempenho e o custo mudassem.
Resultados
Durante a implantação inicial em produção, no fim de junho de 2026, seis agentes corporativos usaram a infraestrutura de GPUs na AWS. A Starya informou que 90,97% do tráfego desses agentes migrados foi atendido pelo Gemma em GPUs dedicadas. Isso demonstrou que um modelo open-weight podia atender à maior parte do tráfego dos agentes selecionados em um ambiente real de clientes.
A implantação também deixou visível o trade-off de desempenho. Nessas cargas de trabalho, a latência de resposta foi de aproximadamente 6,5 segundos no caminho de GPUs, contra 2,8 segundos no caminho de API. A Starya aceitou esse trade-off para os agentes corporativos de texto selecionados. A qualidade do modelo, o tempo de resposta e a economia da infraestrutura passaram a poder ser avaliados de acordo com as necessidades de cada fluxo.
A Starya passou a combinar seu processo de avaliação de modelos com uma plataforma na AWS para rodar inferência dedicada e um gateway que facilitou atribuir o consumo a cada cliente. Somar essa infraestrutura ao Amazon Bedrock deu à equipe mais opções para atender seus agentes conforme os requisitos mudassem.
Para a Starya, o projeto conectou a engenharia de IA à economia de operar um produto. A equipe passou a poder decidir quais modelos e caminhos de inferência se adequavam a cada carga de trabalho, medir as consequências e refinar a plataforma enquanto continuava desenvolvendo seus agentes.
Saiba mais sobre a Starya e o NebulaOS em starya.ai.
Serviços AWS
 Amazon EKS
 Amazon EC2
 Amazon S3
 Amazon Bedrock
 Elastic Load Balancing
Mais cases
Ver todos os cases



Fale com a Elevata
Vamos Projetar Seu Próximo Caso de Sucesso
Mostramos como aplicar cloud, dados e IA com governança para gerar impacto mensurável no negócio.
Entre em contato